失敗を見つける
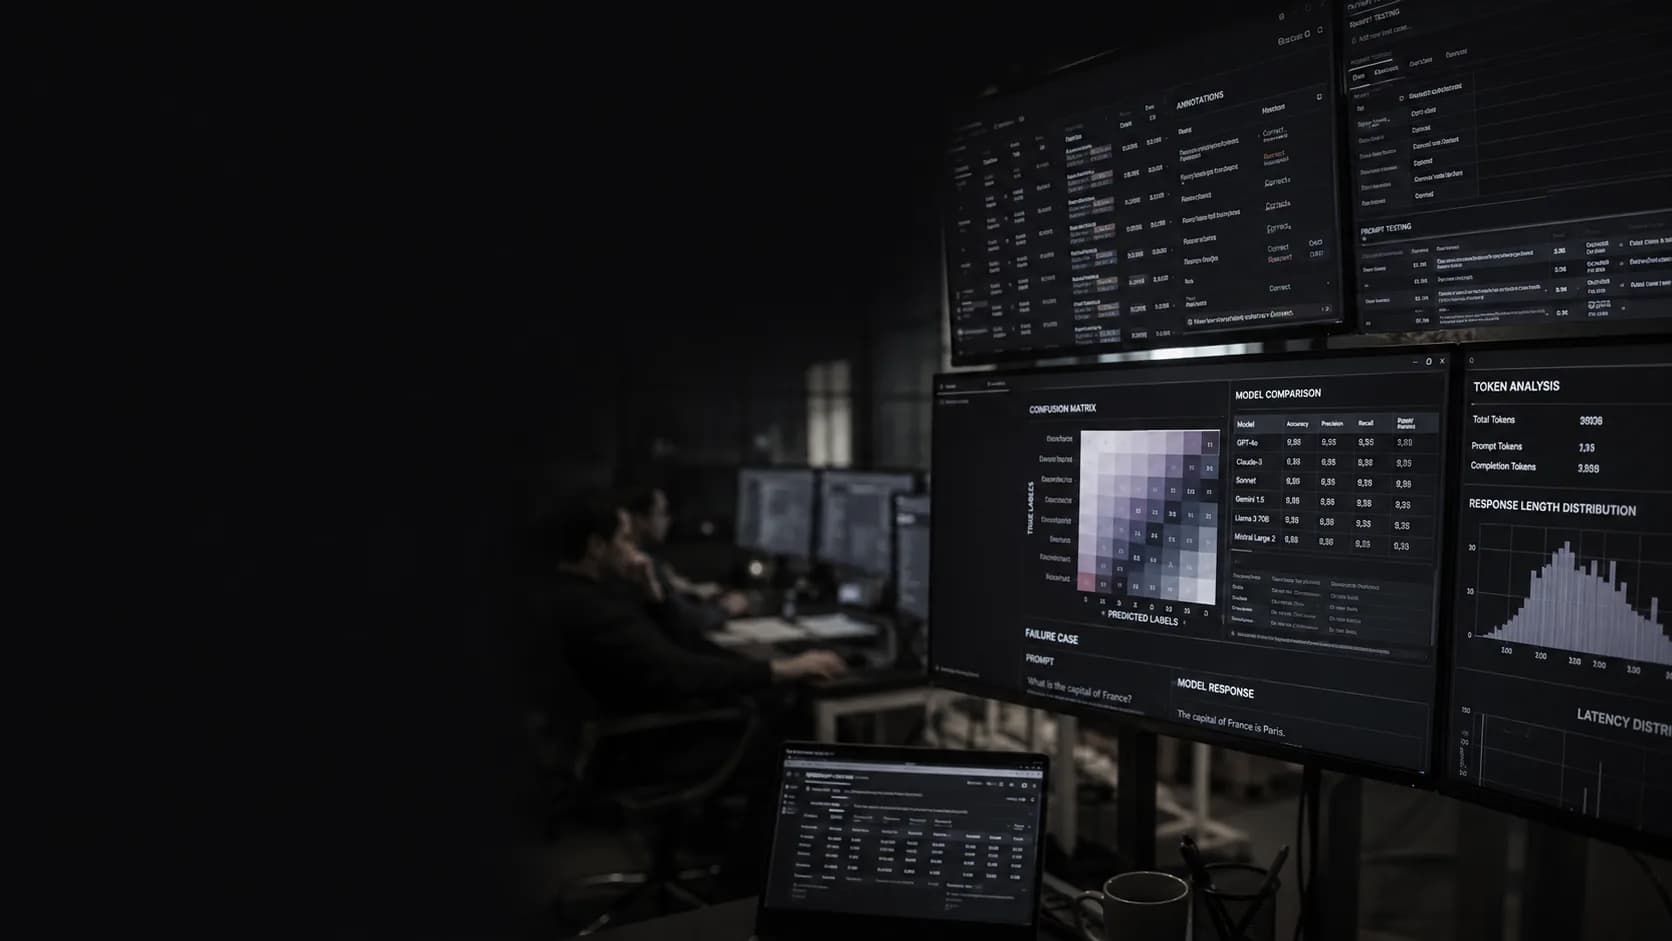
仮定に頼るのではなく、実際の展開でモデルが苦戦している箇所を継続的に特定しましょう。
仮定に頼るのではなく、実際の展開でモデルが苦戦している箇所を継続的に特定しましょう。
次のモデルの反復を改善するために、どの経験や注釈が必要かを正確に特定します。
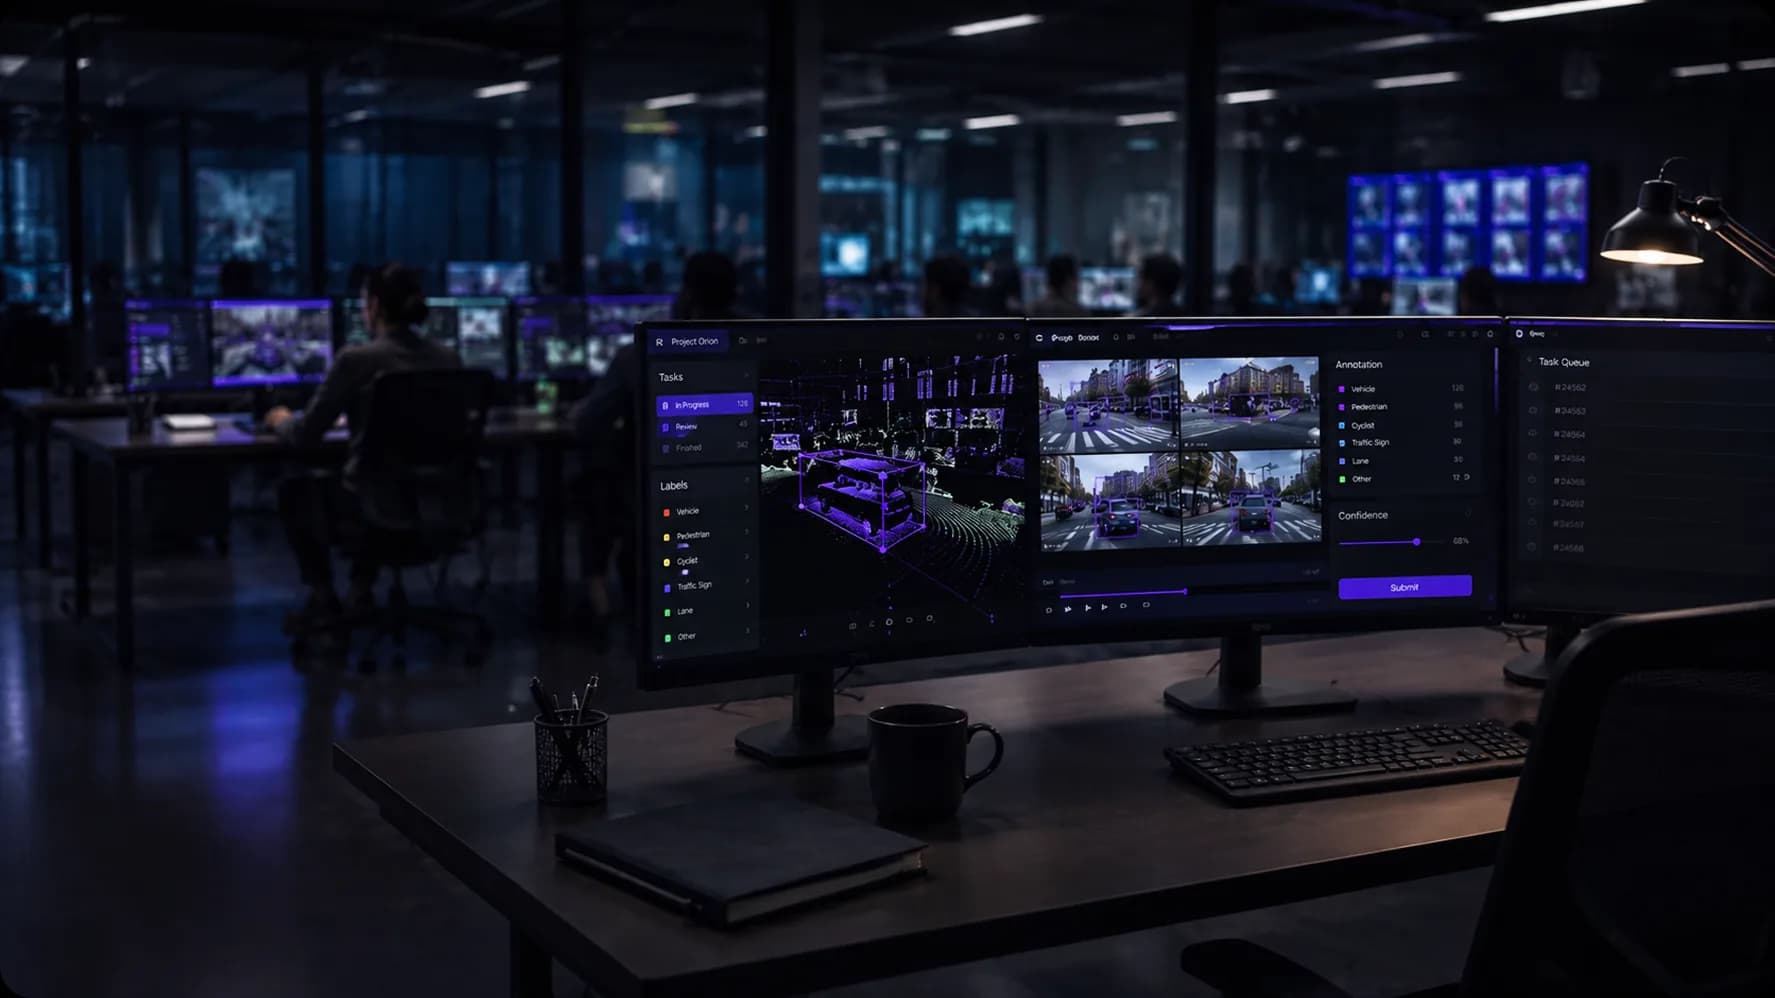
適切なタスクを適切な専門家に割り当て、大規模に高品質なトレーニングデータを生成しましょう。
あなたが展開するモデルは、あらゆるやり取りから学び続けます。
モデル性能を継続的に向上させる自己強化型のデータフライホイール。
よりスマートなデータ。
よりスマートなモデル。
知能は孤立したモデルや断絶したワークフローの集合体として存在すべきではありません。それは観察し、学習し、適応し、時間とともに改善し続ける継続的なシステムとして機能すべきです。
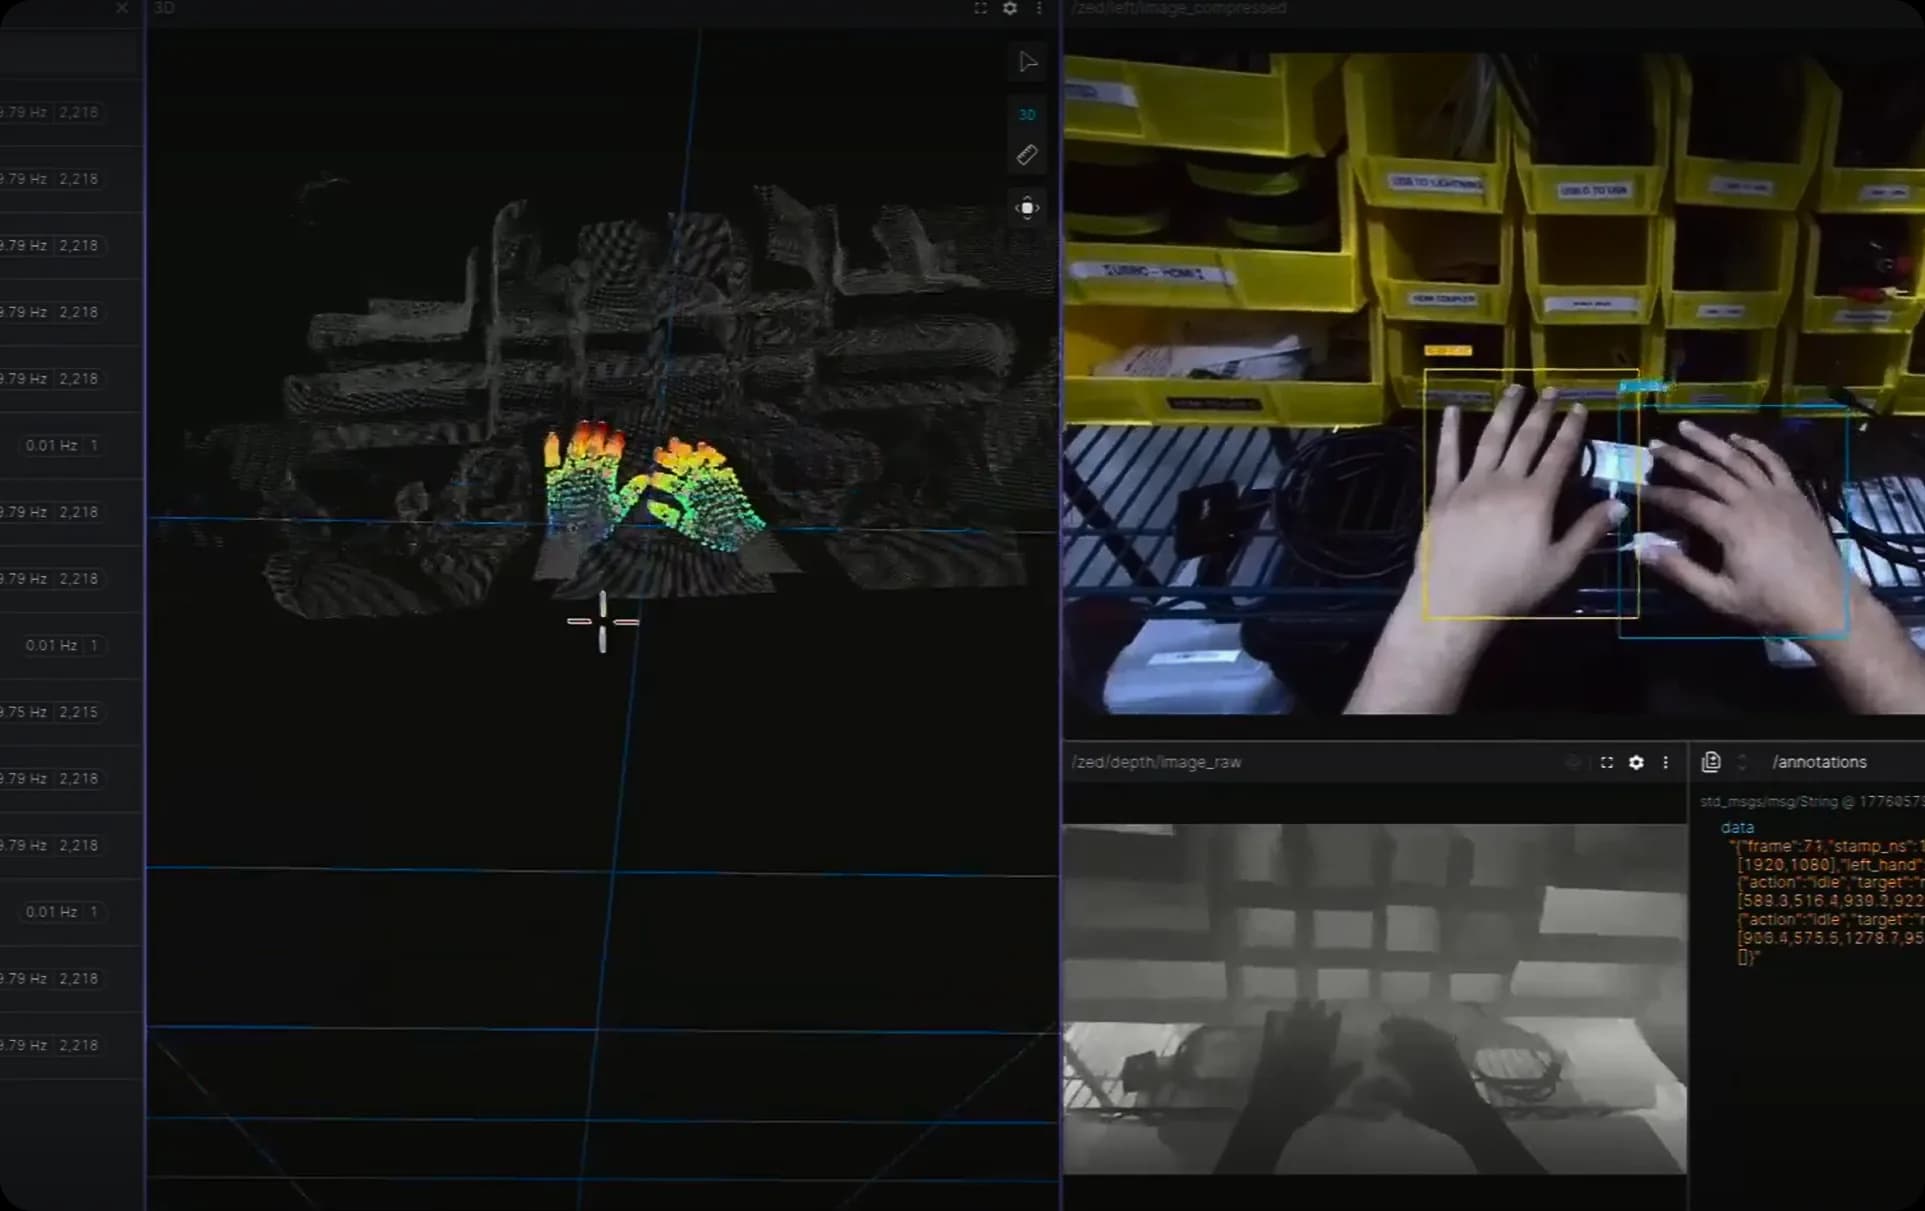
ロボットはインターネットにないものを学ぶために現実世界のデータが必要です。
$18.6B
2024年にロボティクスに投資
↗ 前年同期比31%
2.4x
AI搭載ロボットのさらなる展開(2023–2024年)
企業はモデルのサイズよりも正確性、一貫性、信頼を重視します。
2026年の信頼性優先*
エンタープライズAIの取り組みの中で、2026年の最優先事項は信頼性を挙げています*
57%
本番のLLMの出力は、今日は人間のレビューが必要です*
4.3x
モデル改善よりも誤りのコストが高い*
1対2
企業は信頼性の懸念からAIプロジェクトを延期しています*
*出典:Deloitte 2026 AI Outlook、Gartner、Stanford AI Index 2025
最良のモデルは、トレーニングデータの質や関連性によって制限されます。
>80%
AIプロジェクトの多くは、トレーニングデータの質や利用可能性によって制限されます。
10x
フロンティアAIモデル(MoE時代)により多くの高品質データが必要です*
*出典:マッキンゼー、Scale AI、スタンフォードAIインデックス2025
ボトルネックは計算から正しいデータへと移りました。
— Thoth 論文
すべてのやり取り、すべての失敗、すべての修正がシステムを良くします。
2–5x
継続的学習ループと静的トレーニングによるパフォーマンス向上*
30–50%
継続学習システムによる総所有コストの削減*
*出典:BCG、ウィンドサーフィンAI、スタンフォードAIインデックス2025
ロボティクス、視覚、マルチモーダル推論、RLHF分野の専門家1,000+名。
モデルロードマップと連携して研究・エンジニアリングチームが組むこと。
実際のオペレーター、ライブキャプチャー — テレオペレーション、デモンストレーション、そして大規模な故障復旧。